MIT araştırmacıları GPT-6 Astra ile küçük modellerin ağırlıklarını doğrudan düzenledi
- MIT CSAIL
- OpenAI
- GPT-6 Astra
- Qwen3.5-0.8B
- Gemma 3
MIT CSAIL araştırmacıları 2 Kasım 2026'da paylaştıkları blog yazısında, OpenAI'ın GPT-6 Astra modelinin küçük sinir ağlarının ağırlıklarını gradyan inişi kullanmadan okuyup düzenleyebildiğini bildirdi. Ekip, bu yöntemle Qwen3.5-0.8B modelinin matematik başarısını artırdığını açıkladı. Çalışma hakemli bir makale olarak değil, blog yazısı olarak yayımlandı.
Çalışmayı Rikiya Takehi, Jayden Teoh, Alex Zhang ve Omar Khattab imzalıyor. Ekip, blog yazısında yönteme ağırlık uzayı programlama adını veriyor. Klasik makine öğrenmesi yöntemlerinde ağırlıklar eğitim verisi ve gradyan inişiyle güncellenir. Bu yaklaşımda ise büyük dil modeli, hedef ağın sayısal ağırlıklarını doğrudan okuyup yeniden yazıyor. Deneylerde adı geçen tek büyük model, ChatGPT'nin geliştiricisi OpenAI'ın Eylül 2026'da tanıttığı GPT-6 Astra.
Astra ağırlıklardan neleri çıkardı
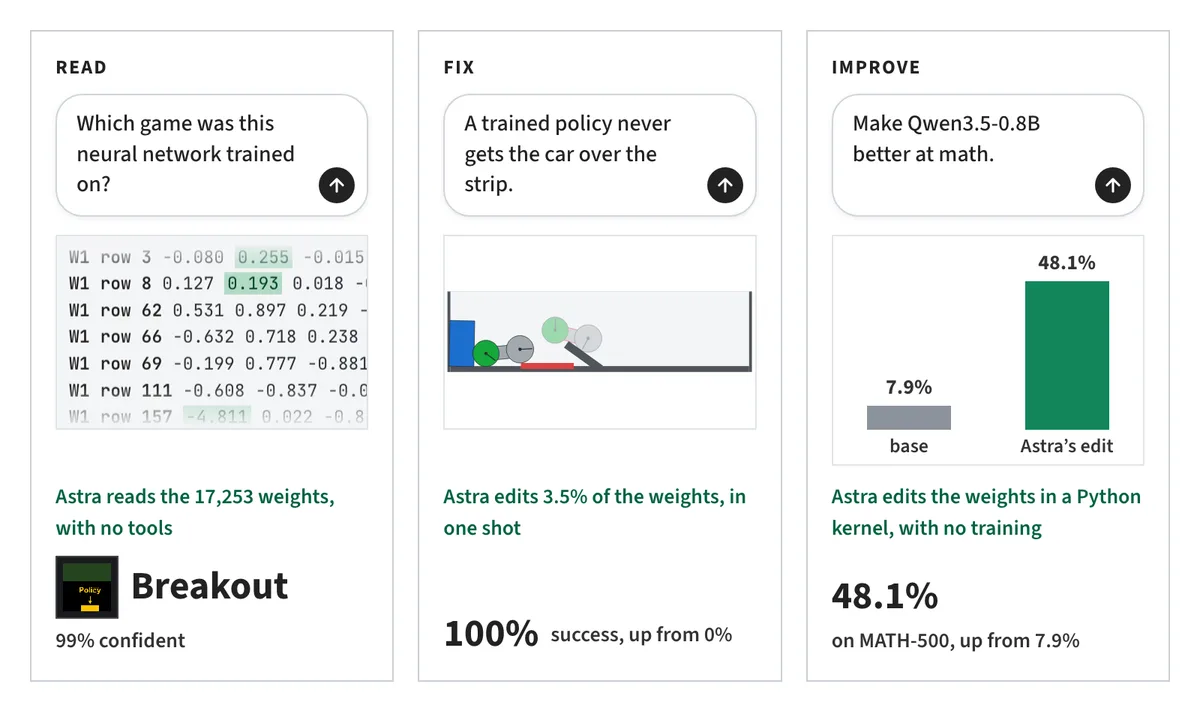
Yazarların aktardığına göre Astra, hiçbir araç kullanmadan 17.253 ağırlığa bakarak dört ızgara oyunu ağının hangi oyun için eğitildiğini doğru buldu. Üç difüzyon modelinin daire, üçgen ya da kare ürettiğini de belirledi. Modeller dolu şekil üretse de Astra şekilleri yalnızca dış çizgi olarak çizdi. Yaklaşık 7,2 milyon parametreli üç küçük dil modelinin Python, romaji ya da İngilizce ile eğitildiğini iki denemenin ikisinde bildi.
Rakamlarla sonuçlar
- Kinetix ortamında 256 denemenin hiçbirinde başarılı olamayan bir araba politikası, ağırlıkların yüzde 3,5'i düzenlendikten sonra 1.024 denemenin tamamını başardı.
- Astra'nın eğitimsiz, sıfırdan yazdığı ağ MinAtar Breakout oyununda 517,4 puan aldı. 500 milyon adım PPO ile eğitilen ağ 25,3 puan topladı. Seaquest oyununda ise Astra'nın ağı 53,1 puanla PPO ağının 88,9 puanının gerisinde kaldı.
- Sıfır ağırlıkla başlatılan 1,48 milyon ağırlıklı 9×9 Go ağı, hiç çalıştırılmadan iki küçük PPO ağına karşı oyunların yarısından fazlasını kazandı. Ağı 50 kez test etme hakkı verildiğinde, 20 milyon oyunla eğitilen eşit boyuttaki PPO ağını yendi.
- Qwen3.5-0.8B modelinde 131.072 ağırlık, yani modelin yüzde 0,016'sı değiştirildi. MATH-500 skoru yüzde 7,9'dan 48,1'e, GSM8K skoru yüzde 13,8'den 67,1'e çıktı.
Qwen deneyindeki en yüksek skorlar, küçük modelin en çok 50 kez çalıştırılıp çıktılarına bakılabildiği ayarda alındı. Yazarlara göre düzenleme, Qwen'in model kartında da uyarılan döngüye girme sorununu 15. ve 19. katmanlarda gideriyor. Cevapların token sınırına takılma oranı yüzde 93'ten 33,1'e indi. Düzenlenmiş model Apache 2.0 lisansıyla Hugging Face'te, deney kayıtları ise GitHub'da yayımlandı.
Sınırlar ve bağlam
Her deney sonuç vermedi. Gemma 3 270M modelinde MATH-500 skoru yüzde 6,8'den en iyi denemede 7,7'ye çıktı. Ekip buradan, ağırlık düzenlemenin önündeki engelleri kaldırabildiği ama eksik yetenek ekleyemediği sonucunu çıkarıyor. Astra, dalkavukluk için eğitilmiş Gemma modelini yalnız ağırlıklara bakarak dört denemenin hiçbirinde bulamadı. Kendi yazdığı metinlerde dikkat örüntülerini inceleyebildiğinde ise üç çiftin üçünde doğru modeli seçti.
Karşılaştırmalar ağırlıklı olarak PPO ile yapıldı, ince ayarla doğrudan bir kıyas raporlanmadı. Yazarlar sonuçları çok erken bulgular olarak tanımlıyor. Bağlam uzunluğunu ve kullanılan araç düzeneğindeki verimsizlikleri sınırlayıcı etken olarak gösteriyorlar. Büyük dil modelleri şimdiye kadar istem, kod ve eğitim düzeni gibi metin tabanlı çıktıları iyileştirmek için kullanılıyordu. Ekip, yaklaşımı sinir ağı ağırlıklarına taşıyan bu çalışmanın ardından bir kıyaslama seti ve araç düzeneği yayımlayacağını duyurdu.
Kaynaklar
Bu haber Instagram ve X'te
Haberin 15 saniyelik videosu. Her gün yapay zeka haberlerini Instagram ve X hesaplarımızda da paylaşıyoruz.